Em nossos esforços para construir soluções de IA robustas e imparciais, é fundamental que nos concentremos no treinamento dos modelos com uma variedade de dados imparcial, dinâmica e representativa. Nosso processo de coleta de dados é extremamente importante para o desenvolvimento de soluções de IA confiáveis. Nesse sentido, a coleta de dados de treinamento de IA por meio de trabalhadores remotos torna-se um aspecto crítico da estratégia de coleta de dados.
Neste artigo, vamos explorar o papel dos trabalhadores remotos, seu impacto no desenvolvimento de algoritmos de aprendizado de IA e modelos de ML, bem como a necessidade e os benefícios que eles trazem para todo o processo.
Por que os trabalhadores da multidão são necessários para construir modelos de IA?
Como seres humanos, geramos toneladas de dados, porém, apenas uma fração desses dados gerados e coletados possui valor. Devido à falta de padrões de referência para dados, a maior parte dos dados coletados é tendenciosa, apresenta problemas de qualidade ou não é representativa do ambiente. Com o crescente desenvolvimento de modelos de aprendizado de máquina e aprendizado profundo que dependem de grandes quantidades de dados, a necessidade de conjuntos de dados melhores, mais recentes e diversificados torna-se cada vez mais evidente.
É onde os trabalhadores da multidão entram em jogo.
Dados de crowdsourcing estão construindo um conjunto de dados com a participação de grandes grupos de pessoas. Os trabalhadores da multidão infundem inteligência humana em inteligência artificial.
As plataformas de crowdsourcing delegam microtarefas de coleta e anotação de dados a um grupo amplo e diversificado de pessoas. O crowdsourcing permite que as empresas acessem uma força de trabalho massiva, dinâmica, econômica e escalável.
A plataforma de crowdsourcing mais popular – Amazon Mechanical Turk – conseguiu obter 11 mil diálogos entre humanos em 15 horas, pagando aos trabalhadores US$ 0.35 por cada diálogo bem-sucedido. A remuneração irrisória que esses trabalhadores recebem evidencia a importância de se estabelecerem padrões éticos para a obtenção de dados.
Teoricamente, parece um plano inteligente, mas não é uma estratégia fácil de executar. O anonimato dos trabalhadores da multidão deu origem a problemas com baixos salários, desrespeito pelos direitos dos trabalhadores e trabalho de baixa qualidade, afetando o desempenho do modelo de IA.
Benefícios de reunir funcionários para obter dados
Ao envolver um grupo diversificado de trabalhadores coletivos, os desenvolvedores de soluções baseadas em IA podem distribuir microtarefas e reunir observações variadas e amplas rapidamente e a um custo relativamente baixo.
Alguns dos benefícios proeminentes de empregar trabalhadores da multidão para projetos de IA são
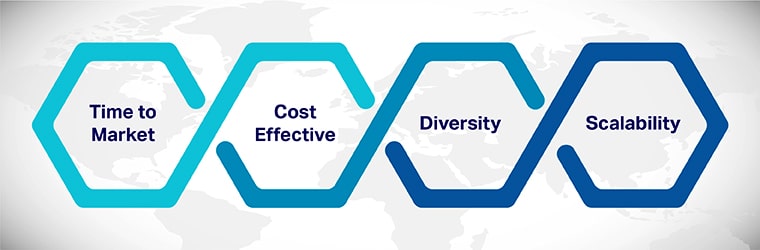
Tempo de lançamento no mercado mais rápido: De acordo com uma pesquisa da Cognilytica, quase 80% do tempo de um projeto de inteligência artificial é gasto em atividades de coleta de dados, como limpeza, rotulagem e agregação. Apenas 20% do tempo é dedicado ao desenvolvimento e treinamento. As barreiras tradicionais à geração de dados são eliminadas, já que um grande número de colaboradores pode ser recrutado em um curto período.
Solução com boa relação custo-benefício: A coleta de dados colaborativa reduz o tempo e a energia gastos em treinamento, recrutamento e integração. Isso elimina os custos, o tempo e os recursos necessários, já que a força de trabalho é contratada por tarefa realizada.
Aumenta a diversidade no conjunto de dados: A diversidade de dados é fundamental para o treinamento de toda a solução de IA. Para que um modelo produza resultados imparciais, ele precisa ser treinado em um conjunto de dados diversificado. Com a coleta colaborativa de dados, é possível gerar conjuntos de dados diversos (geográficos, linguísticos, dialetais) com pouco esforço e custo.
Aumenta a escalabilidade: Ao recrutar trabalhadores remotos confiáveis, você garante a coleta de dados de alta qualidade , que pode ser dimensionada de acordo com as necessidades do seu projeto.

In-house vs. crowdsourcing – Quem sai como o vencedor?
| Dados Internos | Dados de crowdsourcing |
|---|---|
| A precisão e a consistência dos dados podem ser garantidas. | A qualidade, precisão e consistência dos dados podem ser mantidas se plataformas confiáveis de crowdsourcing com medidas padrão de controle de qualidade estiverem envolvidas |
| O fornecimento interno de dados nem sempre é uma decisão prática, pois sua equipe interna pode não atender às demandas do projeto. | A diversidade de dados pode ser garantida, pois é possível recrutar um grupo heterogêneo de crowd workers com base nas necessidades do projeto. |
| Caro para recrutar e treinar trabalhadores para as necessidades do projeto. | Solução econômica para coleta de dados pois é possível recrutar, treinar e integrar trabalhadores com menos investimento. |
| O tempo de lançamento no mercado é alto, pois a coleta interna de dados leva um tempo considerável. | O tempo de lançamento no mercado é significativamente menor, pois muitas contribuições chegam rapidamente. |
| Um pequeno grupo de colaboradores internos e rotuladoras | Um grande e diversificado grupo de colaboradores e rotuladores de dados |
| A confidencialidade dos dados é muito alta com uma equipe interna. | A confidencialidade dos dados é difícil de manter ao trabalhar com grandes grupos de trabalhadores em todo o mundo. |
| Mais fácil de rastrear, treinar e avaliar os coletores de dados | Desafiador para rastrear e treinar os coletores de dados. |
Preenchendo a lacuna entre os trabalhadores de crowdsourcing e o solicitante.
Há uma evidente falta de informação por parte do solicitante, pois os trabalhadores recebem apenas informações referentes à tarefa específica. Por exemplo, embora recebam microtarefas, como gravar diálogos em seu dialeto nativo, raramente lhes é fornecido contexto. Eles não têm as informações necessárias sobre o porquê de estarem fazendo o que estão fazendo e qual a melhor maneira de fazê-lo. Essa falta de informação impacta a qualidade do trabalho realizado por crowdsourcing.
Para um ser humano, ter todo o contexto fornece clareza e propósito ao seu trabalho.
Adicione a essa mistura outra dimensão do NDA – os acordos de não divulgação que limitam a quantidade de informações que um trabalhador coletivo recebe. Do ponto de vista do trabalhador coletivo, essa retirada de informações mostra falta de confiança e diminuição da importância de seu trabalho.
Quando a mesma situação é analisada sob a perspectiva oposta, nota-se a falta de transparência por parte do trabalhador. O solicitante não compreende plenamente o profissional contratado para realizar o trabalho. Alguns projetos podem exigir um tipo específico de trabalhador; contudo, na maioria dos projetos, há ambiguidade. A realidade é que isso pode complicar a avaliação, o feedback e o treinamento posteriormente.
Para combater essas dificuldades, é importante trabalhar com especialistas em coleta de dados com histórico de fornecimento de dados diversificados, com curadoria e bem representados de uma ampla seleção de colaboradores.
Escolher Shaip como seu parceiro de dados pode ter vários benefícios. Nós nos concentramos na diversidade e distribuições representativas de dados. Nossa equipe experiente e dedicada entende as compulsões de cada projeto e desenvolve conjuntos de dados que podem treinar soluções robustas baseadas em IA rapidamente.
[Leia também: Guia introdutório de dados de treinamento de IA: definição, exemplo, conjuntos de dados ]