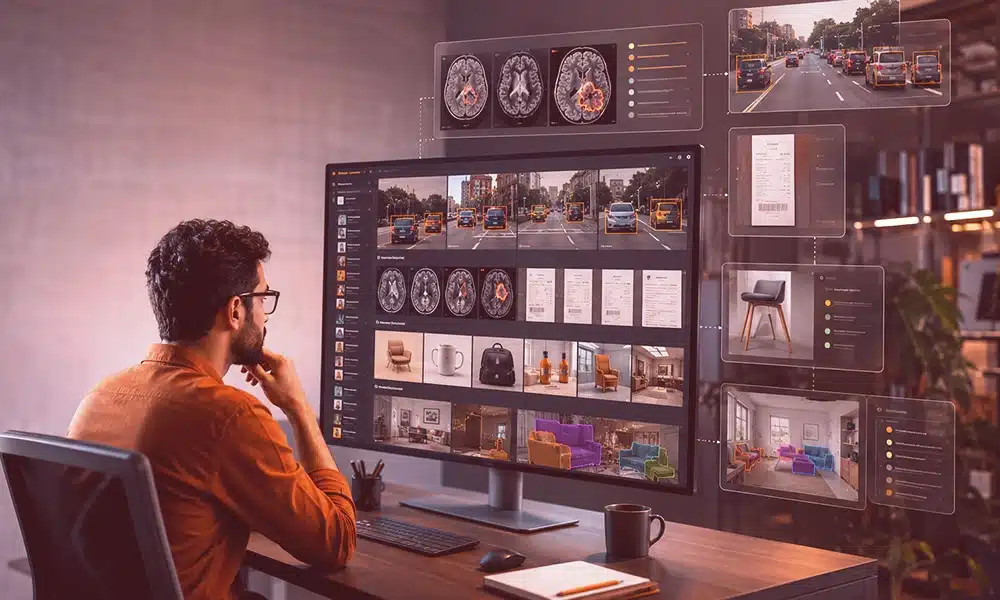
Um modelo de visão computacional só é tão preciso quanto as imagens com as quais é treinado. Alimente-o com um conjunto de imagens limpo e bem rotulado e ele aprenderá a detectar tumores, ler recibos ou manter um carro autônomo na faixa. Alimente-o com ruído e ele cometerá erros com frequência. É por isso que os conjuntos de dados de imagens corretos para visão computacional são mais importantes do que a arquitetura do modelo para a maioria das equipes iniciantes — e por que os conjuntos de dados gratuitos e de código aberto continuam sendo a maneira mais rápida de criar protótipos antes de investir em dados personalizados.
A seguir, apresentamos 22 dos conjuntos de dados de código aberto mais úteis, agrupados por tarefa, além de um breve guia sobre como escolher um e onde buscar outras opções além desta lista. O mercado global de visão computacional foi avaliado em US$ 20.75 bilhões em 2025 e a projeção é de que cresça de US$ 24.14 bilhões em 2026 para US$ 72.80 bilhões em 2034 ( Fortune Business Insights, 2025 ), portanto, a demanda por imagens de treinamento de alta qualidade só tende a aumentar.
Principais lições
- Conjuntos de dados de imagens de código aberto Permite que você crie protótipos de modelos de visão computacional gratuitamente antes de encomendar dados personalizados.
- Associe o conjunto de dados à tarefa: classificação, detecção ou segmentação, cada uma exigindo rótulos diferentes.
- Conjuntos de dados de referência como ImageNet, COCO e Open Images continuam sendo padrões da indústria.
- Conjuntos de dados gratuitos raramente correspondem exatamente ao seu caso de uso — planeje uma etapa de dados personalizados.
O que são conjuntos de dados de imagens para visão computacional?
Conjuntos de dados de imagens para visão computacional são coleções organizadas de imagens rotuladas, usadas para treinar e validar modelos que interpretam informações visuais. Cada imagem contém anotações — um rótulo de classe, caixas delimitadoras ou máscaras em nível de pixel — que ensinam ao algoritmo o que ele está observando. A anotação é a camada de rotulagem que transforma pixels brutos em sinais de treinamento supervisionado. Sem ela, um modelo tem imagens, mas nenhuma lição para aprender.
Tarefas de conjunto de dados de imagem: classificação, segmentação, detecção e muito mais

A classificação de imagens é uma das tarefas mais fundamentais da visão computacional. Nesse processo, um modelo aprende a atribuir um rótulo a uma imagem inteira com base em seu conteúdo. Por exemplo, um conjunto de dados para classificação de imagens pode ajudar um modelo a distinguir entre imagens de gatos e cachorros, ou a identificar diferentes tipos de plantas. Essa tarefa é crucial para aplicações como marcação automática de fotos, diagnóstico de doenças a partir de imagens médicas e benchmarks de categorização de cenas.
A detecção de objetos vai além, não apenas identificando a presença de objetos em uma imagem, mas também localizando-os com precisão usando caixas delimitadoras. Conjuntos de dados para detecção de objetos, como aqueles que contêm imagens anotadas com caixas delimitadoras, são vitais para aplicações como detecção de pedestres em veículos autônomos, vigilância de segurança e análise de varejo. A detecção de objetos também é um componente essencial no desenvolvimento de algoritmos robustos de visão computacional para cenários do mundo real.

A segmentação semântica envolve a classificação de cada pixel de uma imagem em uma categoria específica, proporcionando uma compreensão detalhada da cena. Essa segmentação trimap em nível de pixel é especialmente importante em tarefas como imagens médicas, onde a delimitação precisa de órgãos ou tumores é necessária, e em ambientes urbanos para direção autônoma, onde a distinção entre ruas, calçadas e veículos é crucial.
Quais são os melhores conjuntos de dados de imagens de uso geral?
Os conjuntos de dados gerais são coleções grandes e amplamente rotuladas, usadas para avaliar modelos e pré-treinar redes antes do ajuste fino em uma tarefa mais específica.
- IMAGEnet — 1.2 milhão de imagens em 1,000 categorias, organizadas pela hierarquia do WordNet. O padrão que impulsionou o aprendizado profundo moderno.
- Google Open Images V7 — aproximadamente 9 milhões de imagens anotadas em 600 classes de objetos, com rótulos, caixas delimitadoras, segmentação e relações.
- CIFAR-10 — 60,000 pequenas imagens coloridas de 32×32 em 10 classes. Um conjunto inicial padrão para experimentos rápidos.
- Conjunto de dados Oxford-IIIT Pet — 37 raças de animais de estimação com etiquetas de raça, caixas de cabeça e segmentação trimap em nível de pixel.
- SA-1B (Segmento Qualquer Coisa) — mais de 11 milhões de imagens e 1.1 bilhão de máscaras, o maior conjunto de dados de segmentação disponível.
- ADE20K — Mais de 25,000 imagens de cenas densamente anotadas, um parâmetro fundamental para segmentação semântica.
- Celebridade — Mais de 200,000 imagens de celebridades com 40 anotações de atributos por imagem.
- YouTube-8 milhões — milhões de IDs de vídeo com rótulos de entidades visuais gerados por máquina para compreensão de vídeo.
Como escolher o conjunto de dados de visão computacional adequado?

Escolha um conjunto de dados considerando três fatores: a tarefa, o tipo de anotação e o domínio. Um projeto de classificação precisa de rótulos de classe; um projeto de detecção precisa de caixas delimitadoras; um projeto de segmentação precisa de máscaras — usar o tipo de rótulo errado desperdiça semanas. Em seguida, verifique a lacuna de domínio. Um modelo treinado com fotos de banco de imagens nítidas geralmente tropeça em filmagens granuladas do mundo real, da mesma forma que alguém que estudou apenas espanhol básico trava em uma conversa rápida na rua. Quanto mais as imagens do conjunto de dados se aproximarem das suas condições de uso — iluminação, ângulo, resolução, dados demográficos — menos treinamento adicional você precisará.
Considere também os termos da licença (muitos conjuntos de dados de pesquisa proíbem o uso comercial), o equilíbrio entre as classes e a precisão dos rótulos. Em centenas de projetos de visão computacional, a equipe de Shaip constata consistentemente que os conjuntos de dados públicos permitem chegar a um protótipo funcional, mas raramente o superam — a precisão em produção quase sempre exige dados que espelhem suas câmeras, ambientes e casos extremos específicos.
Quando é que se deve criar um conjunto de dados personalizado?

Crie dados personalizados quando as lacunas de precisão, cobertura ou conformidade começarem a gerar custos. Imagine uma seguradora de médio porte tentando automatizar orçamentos de danos a veículos: os conjuntos de dados públicos de veículos mostram fotos nítidas de estúdio, mas as solicitações reais de indenização chegam como fotos de celular escuras e desfocadas de para-choques amassados. Nenhum conjunto de dados aberto corresponde a isso, então o modelo tem um desempenho inferior até ser treinado com imagens representativas. Esse é o ponto de inflexão.
Quando os conjuntos de dados públicos não abrangem seus casos extremos, a coleta e anotação de dados personalizadas fornecem imagens que refletem suas condições exatas — incluindo os cenários raros e complexos que determinam se um modelo está pronto para demonstração ou para produção. Dados personalizados também são importantes quando as regras de licenciamento ou privacidade excluem conjuntos de dados públicos, quando suas classes quase não aparecem em conjuntos de dados abertos ou quando a qualidade dos rótulos precisa atender a um padrão mais elevado do que as anotações colaborativas podem garantir. Se o seu projeto ultrapassou o que os conjuntos de dados gratuitos podem oferecer, o próximo passo é definir o escopo dos volumes de coleta, as especificações de anotação e os requisitos de conformidade específicos para o seu caso de uso.
Como a Shaip pode ajudar com conjuntos de dados personalizados de visão computacional?
A Shaip cria conjuntos de dados de imagens personalizados, projetados especificamente para o seu modelo, ambiente e casos extremos — indo além do que qualquer conjunto de dados gratuito pode oferecer. Enquanto os dados abertos são genéricos, nosso trabalho parte do seu problema: as câmeras que você utiliza, a iluminação e os ângulos que você enfrenta, os raros cenários que comprometem a precisão em produção. Veja como isso se traduz em um serviço gerenciado de ponta a ponta: