Em IA física, o modelo raramente é o gargalo — os dados são. Uma política de robô que funciona perfeitamente em uma demonstração e depois trava em um armazém real quase sempre falha nos dados que nunca viu, e não na arquitetura. Isso coloca uma questão orçamentária diante de toda equipe de robótica: ao decidir entre dados sintéticos e dados do mundo real para robótica, qual você deve realmente comprar? Ambos têm pontos fortes reais, ambos têm custos reais, e a resposta certa depende do estágio atual do seu projeto.
Principais lições
- Dados sintéticos são baratos, escaláveis e seguros para gerar casos extremos em grande volume.
- Os dados do mundo real capturam o ruído do sensor e a variabilidade de cauda longa que a simulação não consegue captar.
- A discrepância entre a simulação e a realidade é o principal motivo pelo qual os modelos puramente sintéticos falham na implementação.
- O custo da coleta de dados do mundo real é proporcional às horas de captura; os dados sintéticos são baratos depois de construídos.
- Dados sintéticos preenchem lacunas; dados do mundo real servem de base para o treinamento. O modelo híbrido será o vencedor em 2026.
- Invista em dados sintéticos no início e em dados do mundo real antes de realizar ajustes e implementações.
O que são dados sintéticos para robótica?

Dados sintéticos para robótica são dados de treinamento gerados artificialmente em simulação, em vez de capturados de robôs físicos no mundo real. Um motor de física ou modelo de mundo renderiza cenas, movimentos e leituras de sensores, e rotula cada quadro automaticamente com a verdade fundamental perfeita.
Como o simulador conhece a posição, a massa e o movimento exatos de cada objeto, ele produz rótulos perfeitos a uma velocidade que nenhum processo manual consegue igualar. Os dados sintéticos abrangem quatro tipos principais: visão (imagens segmentadas, iluminação variada), 3D e profundidade (nuvens de pontos, mapas de navegação), movimento (trajetórias, ângulos das articulações, velocidade) e interação (preensão, contato, colisão). A randomização de domínio — que varia deliberadamente cores, texturas e iluminação além dos limites realistas — força os modelos a se concentrarem em características relevantes para a tarefa.
Aleatorização de domínio: Uma técnica que varia a aparência da simulação além dos limites realistas, de modo que os modelos se generalizem para condições reais que nunca foram explicitamente mostradas.
[Leia também: A pilha de conjuntos de dados de IA Física ]
O que são dados do mundo real para a robótica?
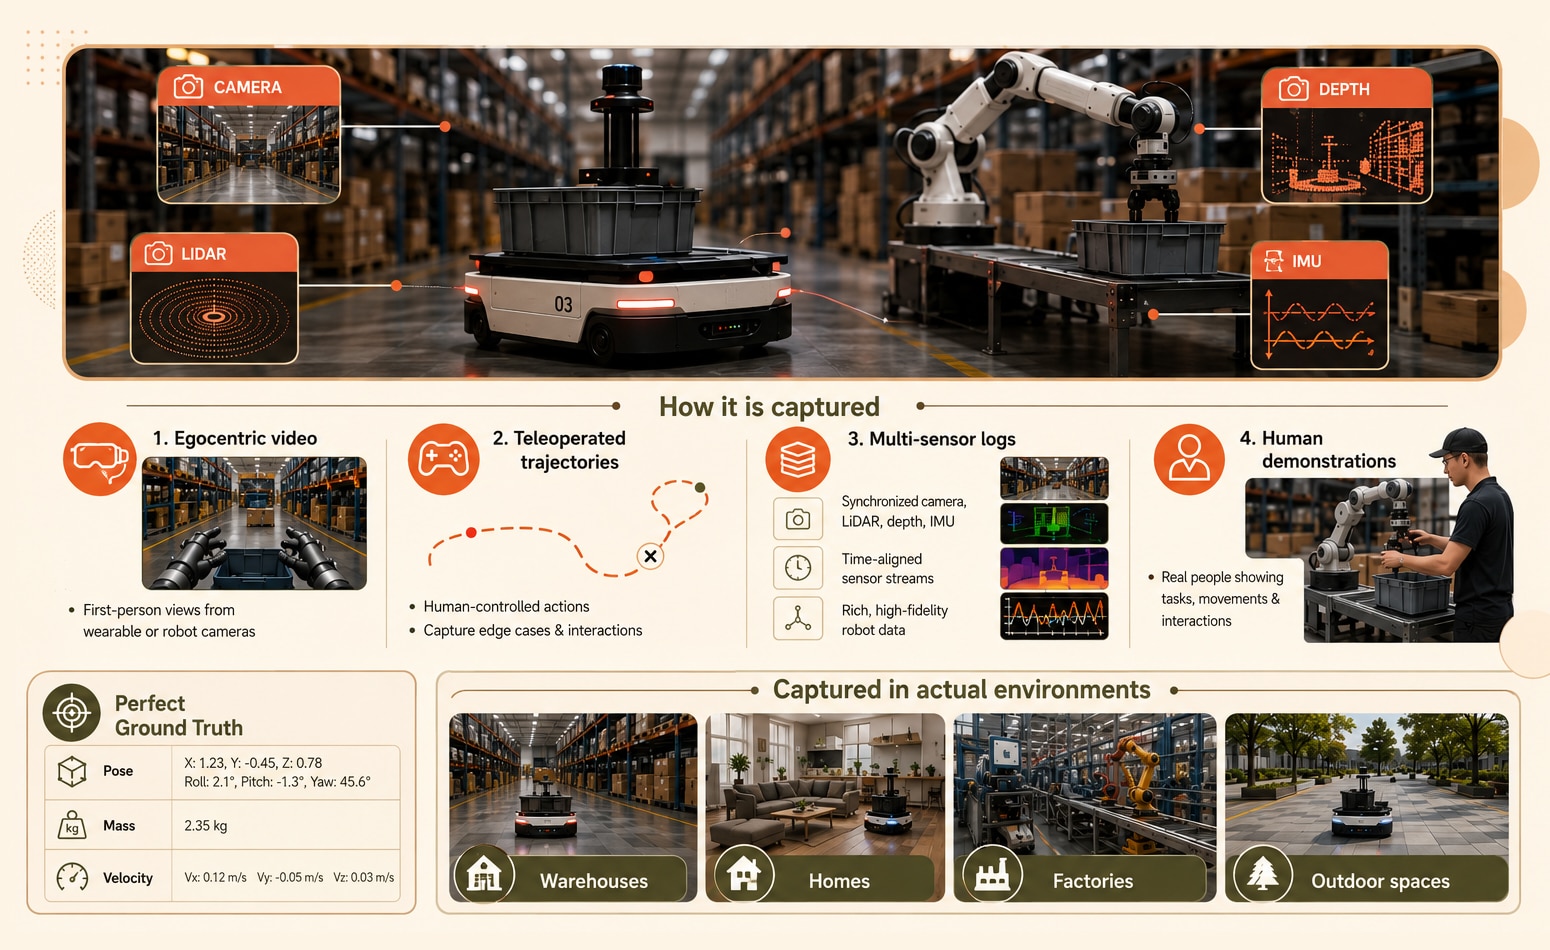
Os dados do mundo real para robótica são dados de treinamento coletados por sensores físicos, teleoperação ou demonstrações humanas em ambientes reais. Eles carregam o ruído real, as variações de iluminação e a variabilidade imprevisível que um robô encontra no momento em que sai do laboratório.
Esses são os dados que fundamentam um modelo na realidade. Incluem vídeo egocêntrico (em primeira pessoa), trajetórias de manipulação teleoperadas, registros multissensoriais combinando fluxos de câmera, LiDAR, profundidade e IMU, e gravações de demonstrações humanas. A coleta de dados do mundo real de Shaip abrange vídeo egocêntrico, teleoperação e captura de manipulação em diversos ambientes globais — exatamente os cenários de alta variância que a simulação tem dificuldade em reproduzir.
Dados egocêntricos: gravações de vídeo e sensores em primeira pessoa, capturadas por uma câmera montada na cabeça, no peito ou no pulso, que espelham o que um robô vê durante uma tarefa.
Dados sintéticos versus dados do mundo real: como se comparam?
Dados sintéticos e dados do mundo real resolvem problemas opostos. Os dados sintéticos são vantajosos em termos de custo, escalabilidade e cobertura de casos extremos; os dados do mundo real são vantajosos em termos de realismo, fidelidade dos sensores e confiabilidade para implantação. A tabela abaixo mapeia as principais compensações que os compradores consideram.
Qual é a diferença entre a simulação e a realidade — e por que isso importa?
A diferença entre simulação e realidade é a queda de desempenho que ocorre quando um modelo treinado em simulação se depara com condições do mundo real que seu treinamento nunca reproduziu. Essa é a principal razão pela qual modelos robóticos puramente sintéticos falham em produção.
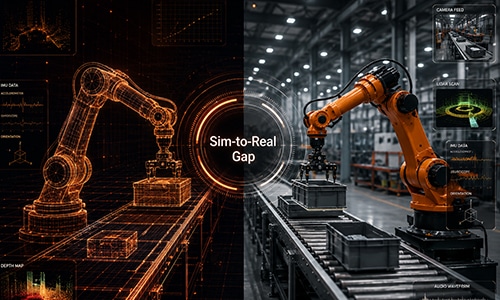
Imagine um piloto que só voou em um simulador. Ele consegue executar com perfeição todos os cenários pré-programados, mas na primeira vez que enfrenta uma turbulência real — daquelas que o simulador suavizou — seu treinamento revela suas limitações. Os robôs se comportam da mesma maneira: um sistema que domina um armazém virtual impecável pode travar quando uma empilhadeira real aparece de um ângulo não modelado, ou quando a luz do sol incide sobre um sensor de uma forma que o renderizador nunca capturou.
As simulações baseiam-se em pressupostos físicos simplificados e raramente modelam artefatos de sensores, casos extremos de materiais ou condições verdadeiramente adversas. Os dados do mundo real preenchem essa lacuna, ancorando o modelo na longa cauda de variabilidade que somente a captura física abrange.
[Leia também: O que os modelos VLA precisam dos dados de treinamento ]
Como se compara o custo dos dados sintéticos com o dos dados do mundo real?
A diferença de custo entre dados sintéticos e dados do mundo real é estrutural, e não apenas uma questão de preço. Os dados sintéticos têm um alto custo inicial para construir o pipeline de geração, após o qual o custo marginal de cada quadro adicional se reduz ao custo computacional. Os dados do mundo real funcionam de maneira oposta: o custo aumenta aproximadamente de forma linear a cada hora de captura física e a cada sequência rotulada.
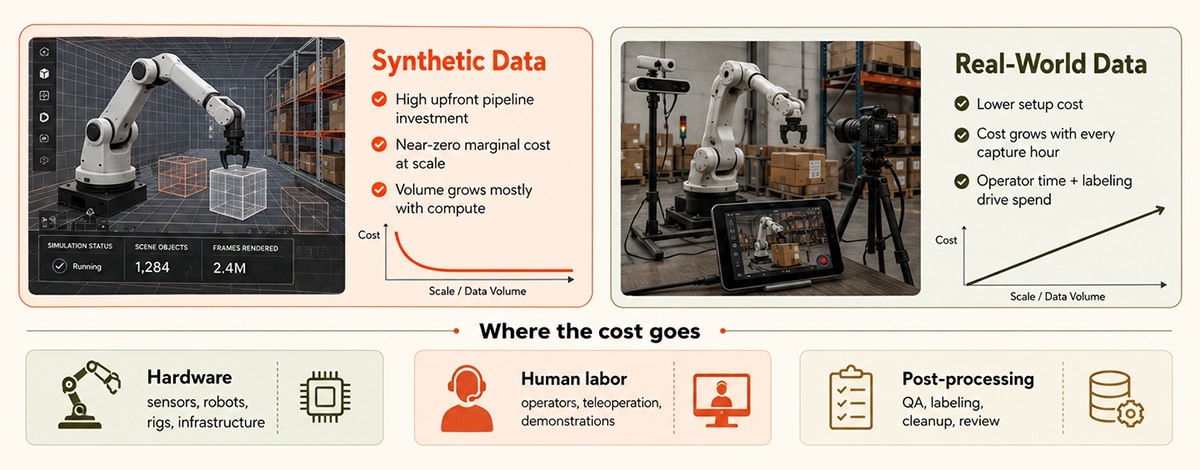
O custo dos dados de treinamento de robôs se divide em três categorias — hardware, mão de obra humana e pós-processamento — e o equilíbrio entre elas depende da sua abordagem:
- Sintético: alto investimento inicial em infraestrutura, custo marginal próximo de zero para aumentar o volume.
- Na prática: configuração inicial mais simples, mas o custo aumenta a cada hora de captura, tempo do operador e etiquetagem.
- Híbrido: o material sintético absorve a carga de alto volume; os gastos reais se concentram onde o realismo é mais importante.
Essa assimetria é o cerne da decisão de compra. Dados sintéticos permitem escalar a baixo custo assim que o pipeline estiver estabelecido, enquanto dados do mundo real concentram o orçamento à medida que a implementação se aproxima. No entanto, menor custo não significa menor risco — e é aí que a decisão se torna complexa.
Qual você deve comprar para o seu projeto de IA física?
Adquira dados sintéticos quando precisar de escalabilidade, segurança e velocidade no início do desenvolvimento; adquira dados do mundo real quando precisar reduzir a discrepância entre a simulação e a realidade antes do ajuste fino e da implementação. A fase do seu projeto, e não a ideologia, deve determinar essa escolha.
Imagine uma empresa de logística de médio porte construindo um robô móvel autônomo para um novo centro de distribuição. Inicialmente, sem nenhum equipamento físico no chão de fábrica, eles dependem quase que exclusivamente de dados sintéticos — gerando milhares de layouts virtuais de corredores, derramamentos e quase colisões com empilhadeiras para pré-treinar a percepção e a navegação com segurança. Conforme as primeiras unidades físicas chegam, o cenário se inverte: eles investem na captura de imagens reais de suas instalações para refinar o comportamento e lidar com peculiaridades que nenhum simulador previu — pisos reflexivos, o brilho de uma doca de carga às 4h, um palete envolto em um filme incomum. Os dados sintéticos os colocaram em movimento; os dados do mundo real os tornaram implantáveis.
Um modelo prático de tomada de decisão:
- Pré-hardware ou P&D inicial → priorização de experimentos sintéticos para pré-treinamento e testes de estresse.
- Cenários raros, perigosos ou sensíveis à privacidade → sintéticos para gerá-los com segurança em grande escala.
- Ajuste fino para um ambiente específico → dados do mundo real desse ambiente.
- Validação e certificação de segurança → dados do mundo real, sempre.
Por que uma estratégia híbrida de dados para robótica será a vencedora em 2026
Uma estratégia híbrida de dados para robótica utiliza dados sintéticos para preencher lacunas específicas, ao mesmo tempo que ancora o treinamento em dados do mundo real, fundamentando o modelo em uma variabilidade genuína. Essa é a abordagem que as equipes de produção adotam quando os projetos-piloto com dados exclusivamente sintéticos atingem o limite da transição entre simulação e realidade.
O raciocínio é simples. Dados sintéticos fornecem o volume e os casos extremos; dados do mundo real fornecem o realismo e a confiabilidade. A Shaip ancora programas de IA física em demonstrações do mundo real e dados egocêntricos, ao mesmo tempo que oferece suporte à geração sintética para a cauda longa — assim, as equipes obtêm escalabilidade sem sacrificar a base que mantém um robô seguro no chão. Para equipes que precisam de conjuntos de dados prontos rapidamente, o licenciamento de dados selecionados e prontos para uso pode encurtar ainda mais o caminho.
Como avaliar um parceiro de dados em robótica?
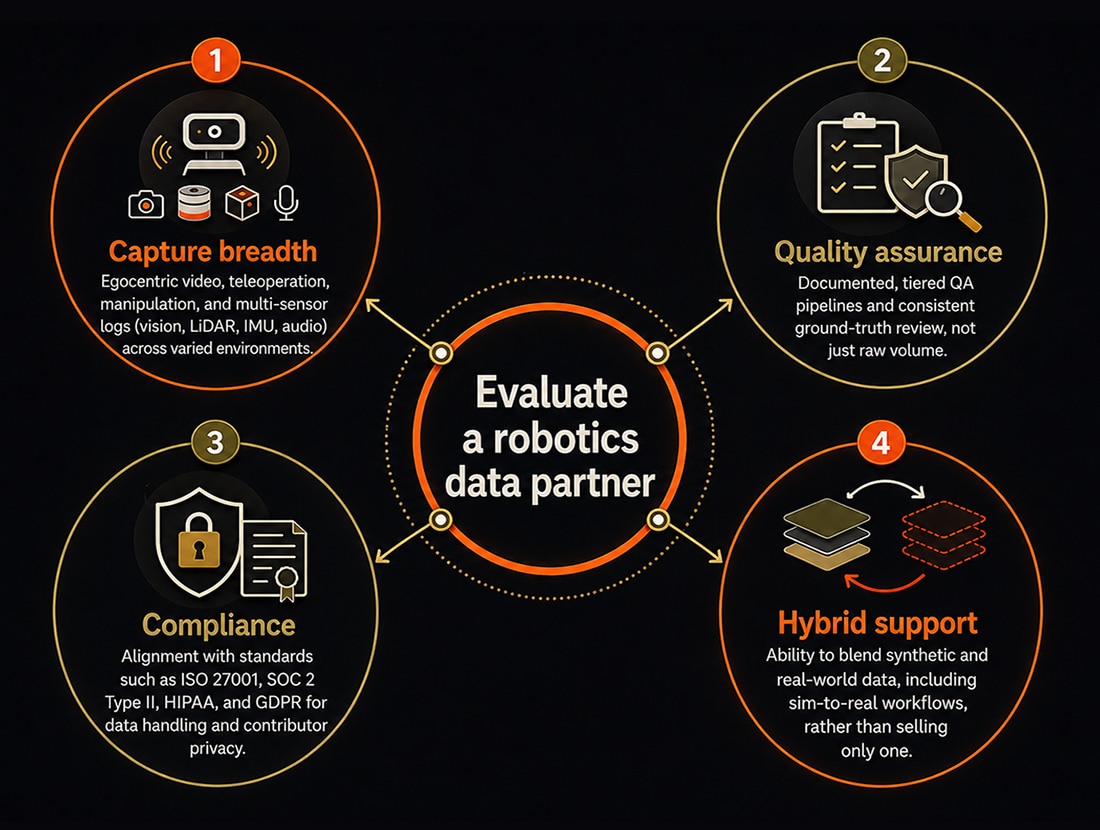
Avalie um parceiro de dados robóticos com base na capacidade de captura em situações reais, abrangência, garantia de qualidade e conformidade — e não apenas no preço. Como a coleta em situações reais envolve ambientes sensíveis e colaboradores humanos, a segurança e a governança são tão importantes quanto a precisão das etiquetas.
- Abrangência da captura: vídeo egocêntrico, teleoperação, manipulação e registros multissensoriais (visão, LiDAR, IMU, áudio) em diversos ambientes.
- Garantia de qualidade: processos de controle de qualidade documentados e em camadas, com revisão consistente dos dados reais, e não apenas volume bruto.
- Conformidade: alinhamento com normas como ISO 27001, SOC 2 Tipo II, HIPAA e GDPR para tratamento de dados e privacidade dos colaboradores.
- Suporte híbrido: a capacidade de combinar dados sintéticos e do mundo real, incluindo fluxos de trabalho de simulação para realidade, em vez de vender apenas um deles.
Em todos esses critérios, os serviços de dados de IA Física da Shaip são projetados para equipes de robótica e IA incorporada, atuando como um parceiro completo — abrangendo coleta multimodal, anotação complexa de VLA e ações, geração de dados sintéticos, RLHF e avaliação, tudo em um único projeto. A Shaip captura dados de ambientes reais onde os modelos operam — cozinhas, armazéns, fábricas, ruas e instalações de saúde — por meio de uma rede global de coleta gerenciada, em vez de crowdsourcing aberto, com controles em conformidade com as normas ISO 27001, SOC 2 Tipo II, HIPAA e GDPR.
Essa experiência se mostra em grande escala. Em um programa de robótica humanoide, a Shaip construiu toda a infraestrutura de operações de dados — configuração de cena mapeada por QR Code, rastreamento com cinco sensores, ensaio moderado e controle de qualidade pronto para o modelo — para gerar 10,000 horas de dados de movimento em realidade virtual egocêntrica com aproximadamente 4,000 participantes e 100 tarefas em apenas 30 dias. Leia o estudo de caso completo para ver como o programa foi estruturado, da configuração à entrega pronta para implantação.