

A estimativa de pose é a tarefa de visão computacional de localizar pontos-chave do corpo — articulações e pontos de referência faciais — e conectá-los em um esqueleto que descreve como uma pessoa ou objeto está posicionado e se move. Para a IA física, esses dados de movimento esquelético são a ponte que transforma o movimento humano observado em ações que um robô pode imitar e executar.
É nessa última frase que a atenção da indústria se voltou discretamente. Por uma década, a estimativa de poses se restringiu a aplicativos de fitness e transmissões esportivas — útil, mas limitada. Agora, os mesmos pontos-chave e estruturas se tornaram um sinal fundamental de treinamento para robôs humanoides, sistemas autônomos e modelos de visão-linguagem-ação. Quando um robô aprende a despejar, empilhar, classificar ou entregar algo a uma pessoa, muito do que ele aprendeu veio da observação de como os humanos faziam isso primeiro — e essa observação são os dados de pose.
O que a estimativa de pose realmente captura
Em sua essência, a estimativa de pose detecta um conjunto de pontos-chave — pontos de referência anatômicos como ombros, cotovelos, pulsos, quadris, joelhos e tornozelos, além de pontos faciais como olhos, nariz e orelhas — e os conecta em um esqueleto que representa a postura e o movimento. Ao rastrear esse esqueleto ao longo dos quadros, obtém-se uma descrição compacta e legível por máquina de como um corpo se move ao longo do tempo.
O campo se divide em algumas linhas familiares. A estimativa de pose humana se concentra em pessoas; as mesmas técnicas se estendem a animais e objetos. A detecção pode ser 2D (localizando pontos-chave como coordenadas de pixel x, y) ou 3D (adicionando profundidade, z, para um esqueleto espacial verdadeiro). Existem outras escolhas de camadas do modelo — detecção de uma ou várias pessoas, por exemplo — mas essas são decisões de arquitetura para a equipe do modelo, não propriedades dos dados de treinamento. O que determina se um modelo de pose é bem-sucedido não é a estratégia de detecção; é a precisão, a consistência e a cobertura dos pontos-chave a partir dos quais ele aprendeu. Esse é um problema de dados, e é a parte que as equipes subestimam.
Por que os dados de pose são o elo perdido para a IA física?
Um sistema de IA física precisa fechar um ciclo que um chatbot jamais consegue: perceber o mundo, decidir e então agir fisicamente. A percepção amadureceu — os robôs conseguem enxergar. A dificuldade está em fundamentar o que eles veem em ações coordenadas e fisicamente corretas, e os dados de postura e movimento são o que as fundamenta.
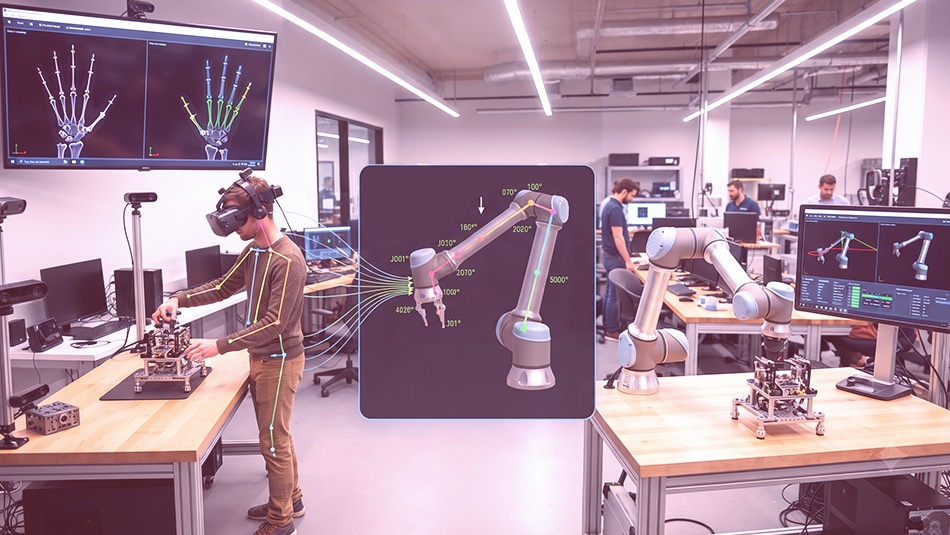
Considere como os modernos sistemas de aprendizado de robôs adquirem habilidades. Demonstrações reais de robôs, capturadas por meio de teleoperação, são precisas, mas lentas e caras de coletar. Por isso, as equipes estão cada vez mais pré-treinando com algo muito mais abundante: vídeos de humanos realizando tarefas. Pesquisas recentes em robótica mostraram que políticas pré-treinadas com vídeos egocêntricos de humanos em larga escala podem generalizar melhor do que aquelas treinadas apenas com dados de robôs, porque os vídeos de humanos carregam a diversidade, a física e a estrutura da tarefa que os dados de robôs coletados em laboratório não conseguem reproduzir em grande escala.
Mas vídeos brutos de humanos não são diretamente utilizáveis por um robô. Um robô não tem um corpo idêntico ao seu; ele tem suas próprias articulações, atuadores e graus de liberdade. A estimativa de pose é a camada de tradução. Ao reduzir uma demonstração humana a um esqueleto estruturado — e, crucialmente, a um esqueleto de mão — esse movimento pode ser redirecionado para a cinemática de um robô e transformado em trajetórias de ação que uma política pode usar para treinamento. Essa é exatamente a entrada que os modelos de visão-linguagem-ação (VLA) tanto desejam.
Os dados de postura aparecem em toda a pilha físico-IA de três formas recorrentes: postura do operador capturada durante a teleoperação, postura do trabalhador para robôs colaborativos que precisam compartilhar o espaço com segurança com pessoas e postura de demonstração humana extraída de vídeos egocêntricos em primeira pessoa e redirecionada para a ação do robô. Em todos os casos, a qualidade do esqueleto define o limite da qualidade do movimento que o robô pode aprender.
Da captura de movimento ao movimento robótico
A transição do movimento humano para o movimento robótico geralmente passa por técnicas paramétricas de modelagem corporal 3D que ajustam o corpo inteiro — incluindo as mãos — a pontos-chave estimados, produzindo movimentos fisicamente coerentes a partir de vídeos comuns. Isso é, na prática, captura de movimento sem marcadores. Para a robótica, o corpo ajustado torna-se uma fonte de trajetórias de ação precisas: alcançar, agarrar, levantar, posicionar, soltar, cada fase segmentada e cronometrada. Quanto melhor a anotação da pose subjacente, mais precisa será a trajetória redefinida.
Pose 2D vs. Pose 3D — Qual delas seu robô realmente precisa?
Essa é a pergunta que as equipes de robótica mais fazem, e a resposta honesta é: depende do que o robô precisa fazer com a pose.
A estimativa de pose 2D fornece pontos-chave no plano da imagem. É suficiente para verificação de forma, reconhecimento de gestos e classificação de atividades, além de ser mais barata para capturar e mais rápida para anotar. Mas não consegue dizer a que distância a mão está da caneca, ou o ângulo real de uma articulação no espaço.
A estimativa de pose 3D adiciona o eixo de profundidade, produzindo um esqueleto métrico posicionado em três dimensões. Para manipulação — agarrar, posicionar, tarefas com alto nível de contato — isso geralmente é imprescindível, pois os pontos de preensão e os ângulos das articulações precisam de precisão métrica no momento em que um robô precisa tocar algo. A pose tridimensional é normalmente recuperada com câmeras estéreo ou de profundidade, LiDAR, sistemas multicâmera ou conversão de 2D para 3D, e isso tem um custo maior tanto na captura quanto na anotação.
A regra que damos aos clientes é a seguinte: se o seu sistema só precisa entender o movimento, o 2D pode ser suficiente; se ele precisa reproduzir o movimento no mundo físico, planeje para o 3D — e projete sua pilha de sensores e esquema de anotações em torno disso desde o primeiro dia, não depois da primeira tentativa frustrada de agarrar.
Postura e destreza das mãos
Se a postura do corpo leva um robô até o objeto, a postura da mão permite que ele tenha sucesso uma vez lá. A manipulação precisa depende do rastreamento minucioso das articulações dos dedos, pontos de contato e configuração da preensão — frequentemente vinte ou mais pontos-chave por mão. É aqui que grande parte da IA física encontra gargalos atualmente, e onde o padrão de anotação é mais elevado. Dados combinados de vídeo e postura da mão provaram ser poderosos para o ensino de manipulação; produzi-los de forma confiável e em grande volume é uma disciplina especializada.
Onde os dados de pose falham
Os modelos de pose falham de maneiras previsíveis, e quase todas as falhas estão relacionadas aos dados de treinamento, e não à arquitetura:
- Oclusão Os membros se escondem atrás dos torsos, as mãos desaparecem atrás de objetos, os sujeitos saem do enquadramento. A forma como você identifica os pontos-chave ocultos, seja identificando-os honestamente ou apenas adivinhando, influencia a confiabilidade do modelo.
- Sobreposição de várias pessoas. Quando corpos se cruzam, pontos-chave são trocados ou fundidos, por isso o rastreamento rigoroso da identidade é fundamental.
- Variações no ponto de vista, iluminação e vestuário. Um modelo treinado apenas com imagens limpas, frontais e bem iluminadas entra em colapso no mundo real.
- Ambiguidade de profundidade. Para poses 3D, inferir profundidade a partir de visualizações limitadas é inerentemente difícil e exige anotações consistentes para evitar o ensino de geometria incorreta.
- Movimento dinâmico. Movimentos rápidos causam desfoque e desvios entre os quadros; os pontos-chave devem permanecer estáveis ao longo do tempo, e não apenas corretos em quadros individuais.
- Consistência anatômica. Uma marcação no pulso em um quadro e no meio do antebraço no seguinte contamina silenciosamente o conjunto de dados.
A ideia central: um modelo de pose herda todas as inconsistências em seus pontos-chave e, na IA física, essas inconsistências se transformam em movimentos incorretos — e às vezes perigosos. A disciplina do processo de anotação é tão importante quanto o volume bruto de dados.
Por dentro de um pipeline de poses real: o projeto de pontos-chave de 150,000 frames de Shaip
Para um cliente de visão computacional, Shaip anotou 150,000 frames de imagem e vídeo usando um esquema personalizado de 36 pontos-chave — pontos de referência faciais mais um esqueleto de corpo inteiro — desenvolvido para suportar tanto a estimativa de pose quanto a análise de movimento facial em uma única passagem. O trabalho abrangeu diversas poses, ângulos, iluminação e vestimentas, com oclusão tratada de forma transparente (pontos de referência ocultos sinalizados, nunca inferidos) e cada frame passando por um controle de qualidade estruturado, atingindo um nível de precisão calibrado. O resultado foi um pipeline pronto para produção, que serve de base para os modelos de pose, movimento, condicionamento físico e movimento na área da saúde do cliente. Detalhes completos estão disponíveis em nosso estudo de caso sobre anotação de pontos-chave do corpo humano.
A conclusão: esse projeto treinou um modelo de movimento humano , mas a disciplina exigida — um esquema personalizado complexo, tratamento preciso de oclusões e diversidade de poses em larga escala — é a mesma disciplina que uma política para robôs humanoides ou colaborativos exige. A aplicação muda; o padrão para os dados, não.
Casos de uso da estimativa de pose: aplicações no mundo real
Os dados de postura e movimento agora treinam sistemas muito além da robótica, e cada área define seu próprio esquema de pontos-chave e nível de precisão. Para as equipes de IA física, a informação útil é que essas são fontes sobrepostas do mesmo recurso — dados de movimento humano de alta fidelidade que podem ser redirecionados para a inteligência incorporada.
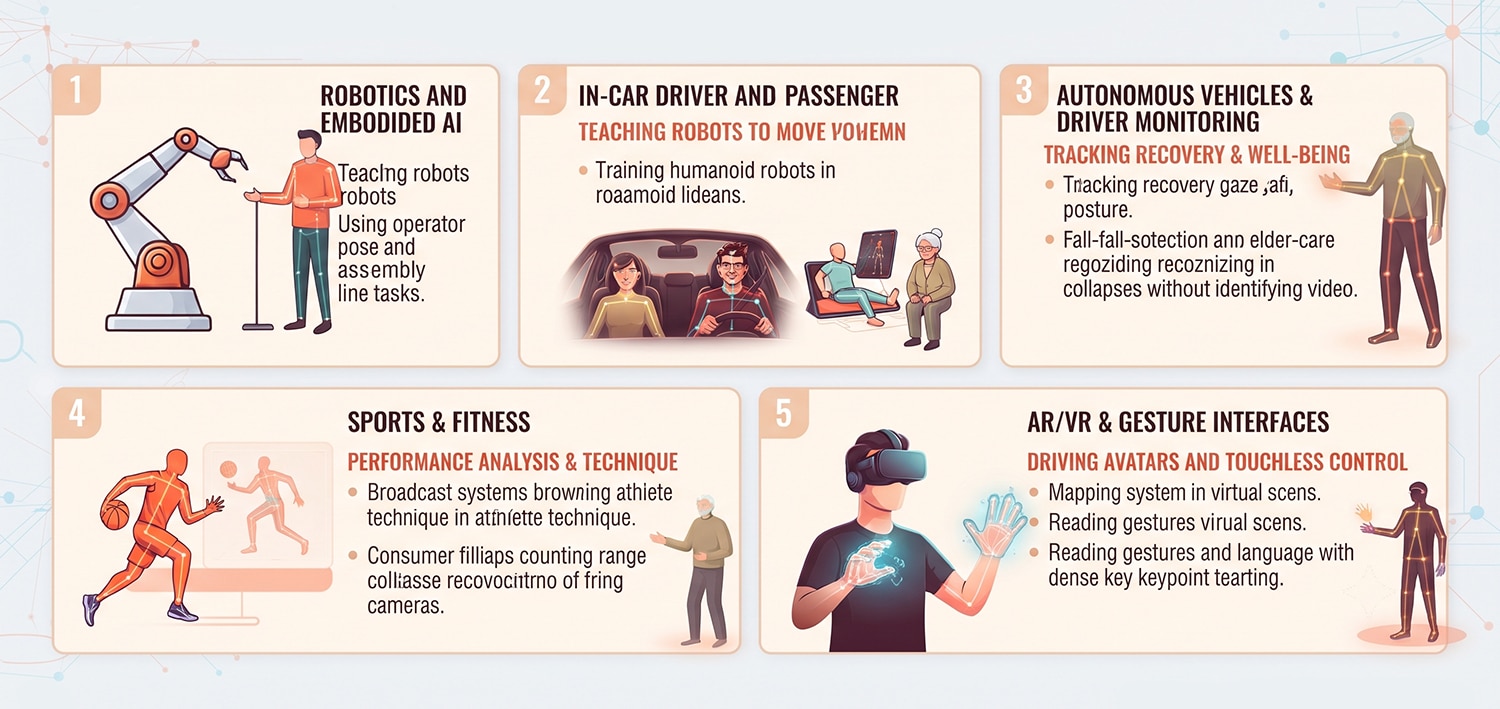
Robótica e IA incorporada — a principal fronteira. Dados de postura ensinam robôs a se moverem aprendendo com a demonstração humana. Um humanoide de armazém, aprendendo a levantar caixas e colocá-las em uma esteira, é treinado em parte com vídeos de pessoas realizando a mesma tarefa, com a postura do operador em sessões de teleoperação fornecendo as trajetórias de ação precisas. Em linhas de montagem, robôs colaborativos usam a postura do trabalhador em tempo real para manter uma distância segura e entregar peças sem colisões — o tipo de tarefa de manuseio de caixas e operações na linha de montagem que está sendo testada em fábricas de logística e automotivas.
Veículos autônomos e monitoramento do motorista. Dentro da cabine, a estimativa de postura rastreia a posição da cabeça, o olhar e a postura da parte superior do corpo do motorista para detectar sonolência ou distração. Os sistemas de monitoramento do motorista que equiparão os novos veículos para atender aos requisitos de segurança do Euro NCAP de 2026 dependem exatamente desses dados de pontos de referência faciais e pontos-chave.
Saúde e reabilitação. A estimativa de postura mede como o corpo realmente se move, informação que os profissionais de saúde utilizam para acompanhar a recuperação. Um aplicativo de fisioterapia pode observar um paciente se exercitando através da câmera do celular, contabilizar a amplitude de movimento e sinalizar posturas incorretas; um sistema de detecção de quedas em um lar de idosos pode reconhecer um colapso apenas pelo movimento esquelético, sem precisar armazenar vídeos que identifiquem o ocorrido.
Esportes e condicionamento físico. O rastreamento esquelético transforma vídeos comuns em dados de desempenho. Sistemas de transmissão sobrepõem esqueletos em tempo real aos atletas para analisar a técnica, enquanto aplicativos de fitness para o consumidor contam repetições e corrigem a postura usando apenas a câmera do celular.
Interfaces de RA/RV e gestos. A postura do corpo e das mãos controla os avatares e permite o controle sem toque. Um headset que mapeia suas mãos em uma cena virtual, ou uma interface que lê gestos e linguagem de sinais, depende do rastreamento preciso de pontos-chave das mãos sob forte auto-oclusão.
Como escolher um parceiro para dados de pose e pontos-chave
Se você está avaliando quem deve construir seus dados de pose, as questões que diferenciam os fornecedores são operacionais, não superficiais:






