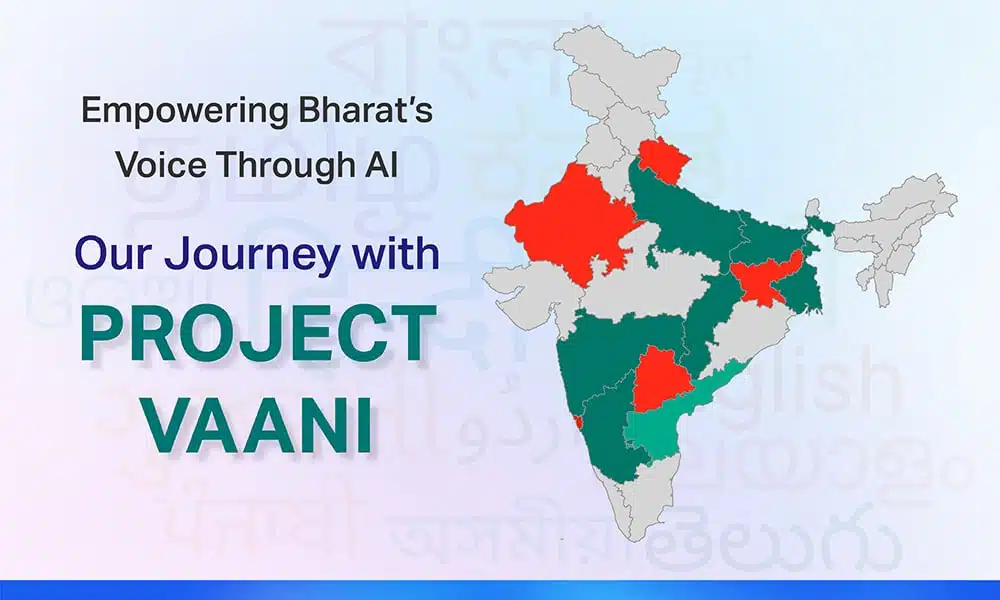
Em um país tão culturalmente diverso e linguisticamente rico como a Índia, a construção de uma IA inclusiva começa com a coleta de conjuntos de dados representativos e de alta qualidade. Essa é a visão por trás do Projeto Vaani — uma iniciativa de código aberto em larga escala, liderada pela ARTPARK , IISc Bengaluru e Google , que visa dar voz a todos os idiomas e dialetos indianos.
A meta ambiciosa? Coletar mais de 150,000 horas de gravações de voz e mais de 15,000 horas de transcrições de 1 milhão de pessoas em 773 distritos da Índia.
Como um dos principais fornecedores para essa missão nacional, a Shaip desempenhou um papel fundamental na curadoria de dados de fala espontânea, transcrição e coleta de metadados, lançando as bases para tecnologias de voz equitativas que realmente representam a Índia real.
A visão por trás do projeto Vaani
O Projeto Vaani foi concebido para reduzir a lacuna de inclusão em IA, criando o maior conjunto de dados multimodal, multilíngue e de código aberto da Índia. Esses dados são fundamentais para o desenvolvimento de sistemas precisos de reconhecimento de fala, tradução e IA generativa em idiomas nativos indianos — muitos dos quais são sub-representados nos ecossistemas tecnológicos globais.
A visão de longo prazo é impulsionar aplicações impactantes em:
- Assistência médica – Telemedicina baseada em voz
- Educação – Plataformas de aprendizagem vernacular
- Governança – Interfaces conversacionais para serviços ao cidadão
- Acessibilidade – Ferramentas de voz para usuários com deficiência
- Resposta desastre – Comunicação em tempo real em dialetos locais
Como Shaip ajudou a construir o maior conjunto de dados de fala de código aberto da Índia para o Projeto Vaani
A Shaip foi encarregada da coleta de 8,000 horas de fala espontânea e 800 horas de transcrições verificadas manualmente . Nossa responsabilidade abrangeu a integração dos participantes, a captura de áudio, a marcação de metadados, a coordenação da transcrição e o controle de qualidade.
8,000 horas de dados de áudio espontâneos
Gravações de mais de 400 falantes nativos por distrito, representando diversas faixas etárias, gêneros e dialetos.
80 distritos, cobertos
Sugestões baseadas em imagens para garantir uma fala natural e contextualizada.
Veja o que tornou nossa abordagem única:
Diversidade em nível distrital
Obtivemos gravações de 80 distritos espalhados por estados como Bihar, Uttar Pradesh, Karnataka, Bengala Ocidental e Maharashtra. Cada distrito contribuiu com 100 horas de dados de áudio, garantindo o equilíbrio regional. Utilizamos falantes nativos, garantindo a representação de sotaques e dialetos regionais frequentemente ignorados nos principais conjuntos de dados de IA.
Representação Linguística e Demográfica
Obtivemos gravações de 80 distritos espalhados por estados como Bihar, Uttar Pradesh, Karnataka, Bengala Ocidental e Maharashtra. Cada distrito contribuiu com 100 horas de dados de áudio, garantindo o equilíbrio regional. Utilizamos falantes nativos, garantindo a representação de sotaques e dialetos regionais frequentemente ignorados nos principais conjuntos de dados de IA.
Discurso orientado por imagem
Para estimular o vocabulário espontâneo e natural, os participantes assistiram a 45 a 90 imagens por sessão e foram solicitados a descrevê-las. Os participantes foram estimulados a usar imagens diversas — desde símbolos culturais a objetos do cotidiano — para obter respostas naturais e espontâneas em sua língua nativa. Isso garantiu que as gravações refletissem a fala contextualizada do mundo real — essencial para o treinamento de sistemas avançados de PNL.
Padrões de transcrição de alta qualidade
Apenas 10% dos dados de fala foram transcritos — totalizando 800 horas. As transcrições foram realizadas por linguistas locais em um raio de 20 a 50 km do falante, garantindo familiaridade com dialetos e nuances. Uma verificação de segunda camada garantiu uma taxa de erro de palavras (WER) inferior a 5%.
Rigorosa garantia de qualidade
Os dados de áudio precisavam atender a um alto padrão: sem ruído de fundo, ecos, vibrações do telefone ou distorções. O áudio foi gravado em ambientes silenciosos e sem eco. Os arquivos foram submetidos a uma revisão rigorosa para atender às diretrizes de clareza da fala, níveis de ruído, precisão dos metadados e verificação do locutor. A marcação dos metadados precisava ser precisa em todos os arquivos, e todas as gravações foram verificadas quanto ao alinhamento do locutor e do local.

Desafios que resolvemos
- Logística remota – Gerenciando equipes em 80 distritos
- Diversidade de falantes – Integração de mais de 32,000 palestrantes verificados em locais remotos
- Sensibilidade cultural – Respeitar os costumes e dialetos locais
- Integridade de dados – Atender aos padrões de qualidade e conformidade
- Controle de qualidade – em múltiplos contextos linguísticos e culturais
Nosso sucesso se deve ao planejamento meticuloso, à validação baseada em tecnologia e às parcerias com equipes locais que entendiam as nuances culturais de cada região.
Impacto e aplicações
A contribuição de Shaip não só acelerou o progresso do Projeto Vaani, como também estabeleceu as bases para uma IA inclusiva na Índia. O conjunto de dados de fala selecionado já está sendo usado para construir e refinar modelos de IA para:
- Assistentes de voz vernáculos
- Motores de tradução regionais
- Ferramentas de comunicação acessíveis para deficientes visuais
- Plataformas de tecnologia educacional baseadas em IA para estudantes rurais
- Telemedicina rural
- Serviços ao cidadão baseados em voz
- Tradução e transcrição em tempo real
Conclusão
O Projeto Vaani é um passo ousado rumo a uma IA inclusiva e acessível, e Shaip se sente honrado em desempenhar um papel fundamental. O trabalho de Shaip no Projeto Vaani reafirma nosso compromisso com a construção de sistemas de IA éticos e inclusivos, fundamentados na diversidade e na representatividade. Com mais de 8,000 horas de fala coletadas e 800 horas transcritas, temos orgulho de ter participado de um dos projetos de inclusão digital mais visionários da Índia.
À medida que o Projeto Vaani avança rumo à sua meta maior de mais de 150,000 horas de dados, estamos prontos para dar suporte à próxima fronteira da inovação em IA que fala com — e para — todos os indianos.
Quer se tornar nosso parceiro na criação de IA que entenda o mundo real? www.shaip.com